 咨询客服
我先查看项目中的开发文档。
项目内有 3 份开发文档,均已读取完成。先看整体结构:
项目文档采用"一个真源 + 一份执行计划"的结构,三份文件职责明确:
| 文件 | 定位 | 规模 |
|---|---|---|
完整开发文档(Markdown).md | 开发基线。产品需求 + 技术方案 | 20 章 + 2 附录 |
docs/开发计划.md | 执行计划。里程碑拆解、人日、阻塞项、质量门禁 | 8 章 + 2 附录 |
docs/README.md | 文档目录说明与生成 Word 版的约定 | — |
一、文档现状
已完成并可作为开发基线:
- 产品与技术开发文档 V1.0 — 20 章 + 2 附录。覆盖产品定位、8 个主导航的信息架构、4 条关键业务流程、25 个 Tauri command 契约、11 张 SQLite 表、11 个任务状态、以及安全合规底线。
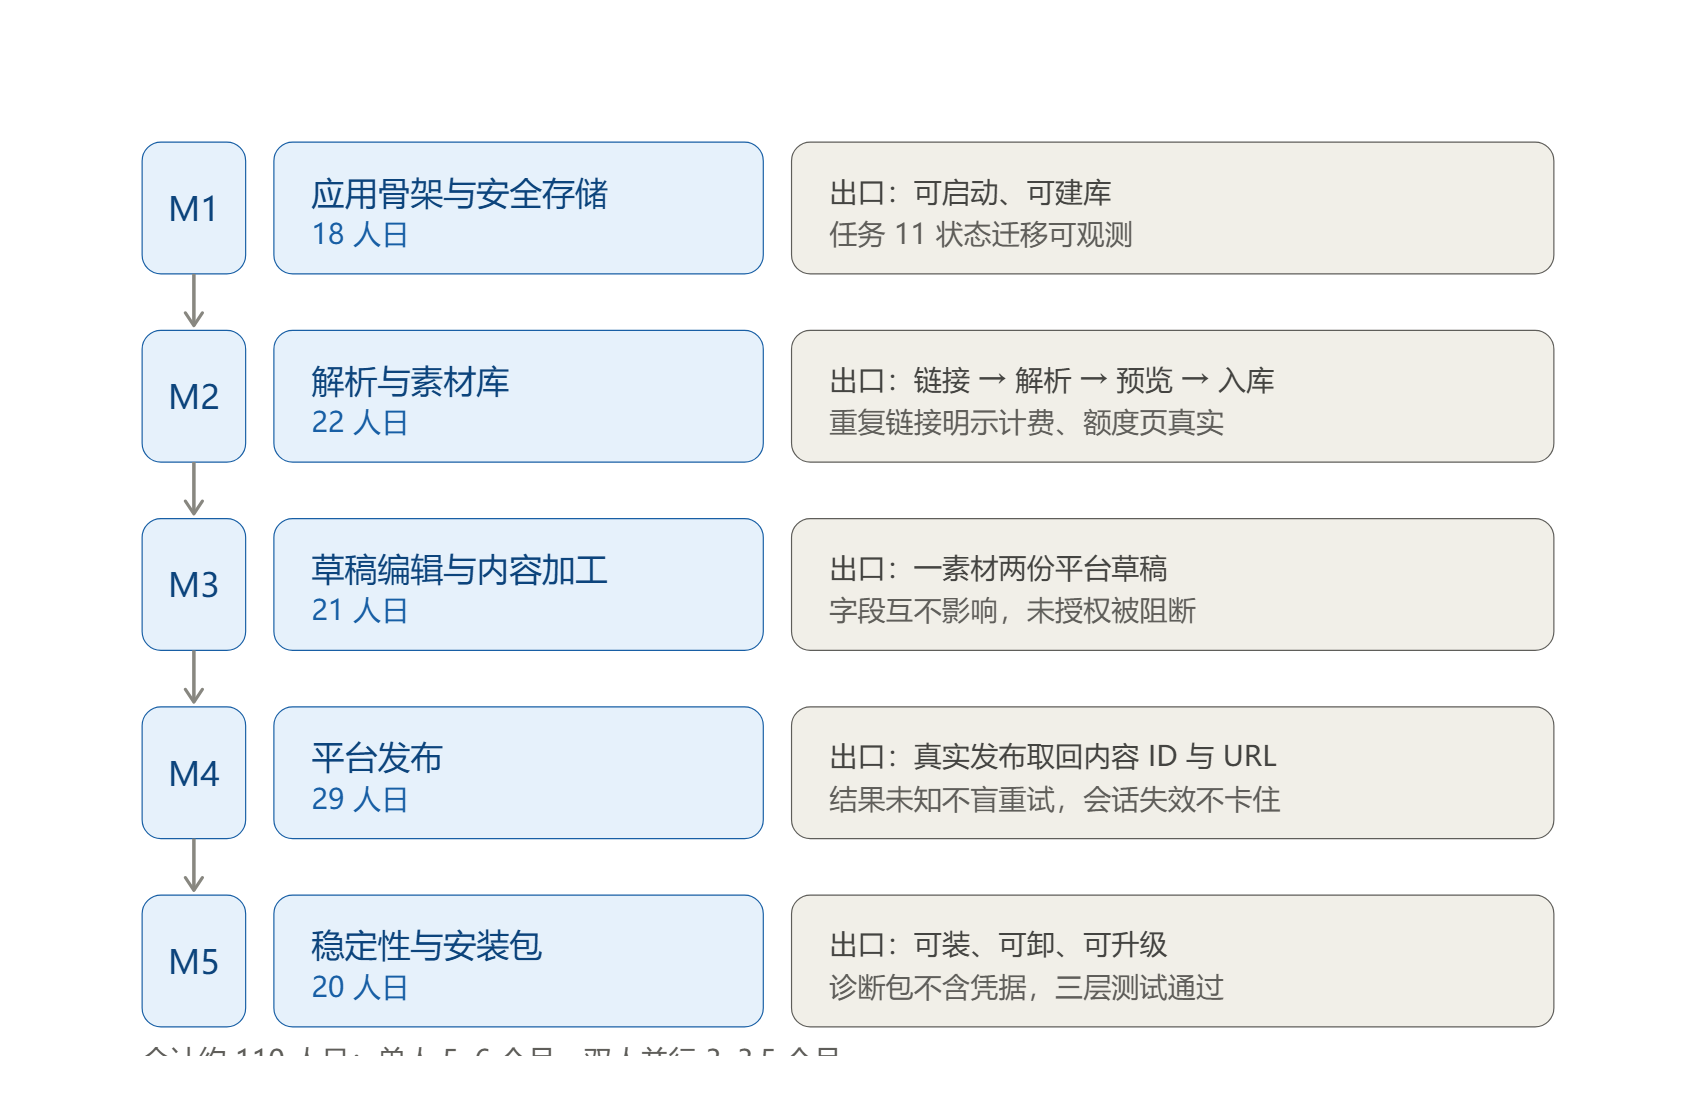
- 开发计划 P1.0 — 5 个里程碑、35 项任务、约 110 人日,含关键路径、质量门禁与风险登记。
- M0 技术验证已通过(2026-10-15)— 解析接口、额度查询、哔站
type=1视频分支、Chromium 1208 与 FFmpeg 1011 共 12 项实测全通,结论留档于spike/m0-parse-api/spike-report.md。
二、技术路线
Tauri 2 + React + TypeScript(前端)/Rust(IPC、SQLite、凭据、进程监管)/Node.js + Playwright sidecar(浏览器)/SQLite(本地权威状态)。
架构上有三处硬约束值得注意:任务系统是全链路地基,必须在 M1 阶段就把 11 个状态、9 类任务、幂等键策略立住并通过测试,否则 M3/M4 的"发布结果未知不盲重试"无法实现;账号中心必须先于浏览器会话落地,因为 profile 路径由 accounts 表 UUID 派生;双轨字段(source_* / edited_*)必须拆列,禁止单列覆盖,否则来源可溯源性失效。
三、M0 实测得出的 7 条硬约束
这些是写解析适配器时最容易踩的坑,计划附录 B 已列为逐条核对清单:
- 响应
content-type实为text/html,必须直接JSON.parse()+ try/catch,不可依据响应头判断; code是字符串,判断须写String(code) === '0001' || '200',不能写code === 200;desc可能是占位符"-",兜底前先过滤['-','无','null','undefined',''];playAddr是带deadline/upsig的临时签名地址,下载须紧跟解析,失败要重调接口取新 URL 而非重试旧地址;video_backup键可能根本不存在,访问前须Array.isArray()判空;author各字段均可为空;- 额度轮询间隔不低于 60 秒。
四、待你确认的 6 项阻塞
| 编号 | 事项 | 阻塞范围 |
|---|---|---|
| B1 | YouTube OAuth 凭据(Google Cloud 项目) | M4,申请周期最长,建议最早启动 |
| B2 | 小红书接口权限(开发者主体 / 应用类目 / 是否获批发布接口) | M4 范围不确定,未获批则降级为"草稿 + 辅助发布" |
| B3 | Chromium 分发策略(随包 / 首次安装 / 用户自配,三选一) | M5 打包方案 |
| B4 | FFmpeg 许可审核 | M3 增强项(转码、裁剪、烧录) |
| B5 | API Key 轮换 | 无阻塞,但 去水印网站的api文档.txt 明文含真实 UID/KEY,属进行中的风险 |
| B6 | type=2 图集 / type=3 实况补测 | 各耗 1 个计费点 |
五、一个范围决策已关闭
关键词搜索能力已确认排除(文档第 7 章已重写)。理由是唯一解析接口只有 url 参数、无任何检索能力,引入第三方爬取需额外数据源授权且与合规底线冲突。实现约束明确:不建 SearchProvider、不建 search_results 表、前端不出现搜索框,仅保留 open_official_bilibili 跳转官方页面的白名单入口。
需要我展开哪一部分?可选:完整阅读某一章原文、按 M1 任务表生成开发任务清单、或直接开始 M1.1 工程初始化。